IDCE数据中心展 | 2026年数据中心行业重大宕机事件盘点
从变压器故障到冷却系统失效,从电池火灾到导弹残骸——2026年,全球数据中心经历了前所未有的密集宕机潮。
概 述
2026年1月至8月,全球主要云服务商和数据中心运营商遭遇了一连串重大服务中断事件。AWS、微软Azure、谷歌云、Oracle Cloud以及多家托管服务商均未能幸免。
与往年不同的是,本轮宕机潮的根因几乎全部指向物理基础设施——电力设备、冷却系统、极端天气,甚至军事冲突——而非传统的软件Bug。这一趋势深刻反映了AI算力需求爆炸式增长与数据中心物理工程能力之间的结构性矛盾。
本文按时间顺序盘点2026年以来最具代表性的重大宕机事件。
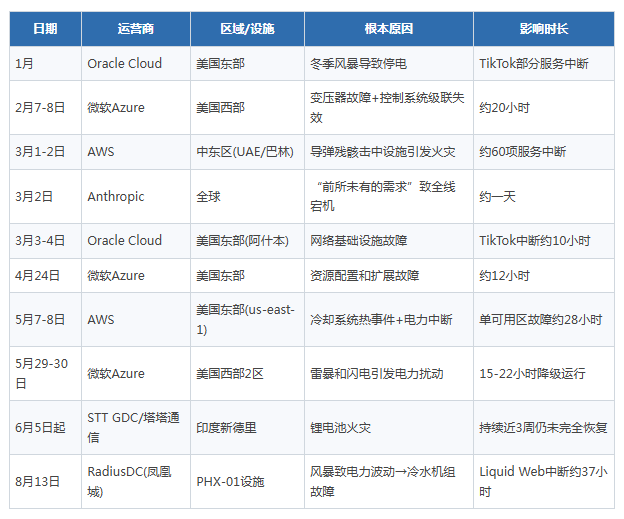
事件时间线总览
一、Oracle Cloud 美国东部宕机(1月)
运营商:Oracle Cloud Infrastructure (OCI)
区域:美国东部
原因:冬季风暴导致数据中心停电。Oracle CEO拉里·埃里森曾在2022年声称其云服务“不会宕机”,此次事件使该言论再度受到质疑。
影响:TikTok美国服务部分中断,这是TikTok USDS合资企业接管美国运营后首次重大服务中断事件。
二、微软Azure 美国西部区域宕机(2月7-8日)
运营商:微软Azure
区域:美国西部(West US,加利福尼亚州)
事件经过:
2月7日
07:52 UTC — 数据中心变压器发生电气故障,UPS电池开始承载负载
07:58 UTC — UPS电池耗尽(仅维持约6分钟),客户开始受到影响
09:31 UTC — 备用发电机恢复约90%的IT机架供电
11:29 UTC — 数据中心完全依靠发电机运行
2月8日
03:42 UTC — 恢复市电供电
04:24 UTC — 事件正式缓解
根本原因:变压器电气故障导致市电中断。虽然发电机如设计启动,但控制系统中的级联故障阻止了从市电到发电机电源的自动切换,导致UPS电池在6分钟内耗尽后完全断电。
受影响服务:Azure Kubernetes Service、Azure Confidential Compute、Azure Site Recovery(讽刺的是,容灾服务本身也宕机了)、Microsoft Store、Windows Update等。六组存储集群受到影响,其中两组恢复缓慢,拖累了整体服务恢复。
关键教训:“冗余”不等于“无关联”。当主备系统共享相同的电力分配和控制平面时,风险只是被隐藏而非被消除。
三、AWS 中东区数据中心遭物理打击(3月1-2日)
运营商:Amazon Web Services
区域:ME-CENTRAL-1(阿联酋)/ ME-SOUTH-1(巴林)
事件经过:
3月1日 约04:30 PST — AWS检测到连接和电力问题
04:51 PST — 官方启动调查
06:09 PST — 确认可用区mec1-az2发生局部电力故障
当天持续进行API层面的修复和流量调度
根本原因:这是全球首次有记录的对主要云服务商物理基础设施的军事打击事件。在地区军事冲突升级期间,不明坠落物(据报道与导弹拦截活动有关)击中了AWS在阿联酋的数据中心设施,产生火花并引发火灾。消防部门强制切断了设施的所有电力——包括主电源和备用发电机——以控制火势。
受影响范围:
· UAE区域:约38项AWS服务中断
· 巴林区域:约46项服务中断
· US-EAST-1:单独出现多服务运营问题
· 下游连锁影响:Snowflake、Anthropic Claude AI、中东和拉美多家金融机构
· Downdetector报告超2,000家企业受影响,全球810万用户报告问题
受影响客户:Careem(中东打车平台)全线中断;支付公司Alaan和Hubpay无法处理交易;阿布扎比商业银行(ADCB)手机银行和呼叫中心暂停;Emirates NBD电话银行服务受影响一天;投资应用Sarwa核心服务中断至周二才恢复;Snowflake宣布中东部署不可恢复。
关键教训:
“如果数据中心成为军事信息传输的关键枢纽,我们预计它们将越来越多地成为网络和物理攻击的目标。”——Zachary Kallenborn,伦敦国王学院博士研究员
IDC全球基础设施研究主管Ashish Nadkarni指出:“保护数据中心现在就像保护最高安全级别的政府办公室一样。”
四、Anthropic Claude 全球性宕机(3月2日)
运营商:Anthropic
原因:“前所未有的需求”(Unprecedented demand)
影响:
API、网页界面、Claude Code全线不可用,持续约一天。
那些围绕单一AI模型提供商构建工作流的企业发现,自己没有任何备用方案。这一事件与AWS中东宕机几乎同时发生,形成了对“单一供应商依赖”的双重警示。
五、Oracle Cloud 美国东部二次宕机(3月3-4日)
运营商:Oracle Cloud Infrastructure (OCI)
区域:美国东部(阿什本,Ashburn)
事件经过:
3月3日 13:24 UTC — Oracle报告服务问题
3月4日 00:44 UTC — 确定根本原因
07:03 UTC — 服务健康指标显示正在恢复
09:24 UTC — 事件标记为已解决
影响:TikTok美国用户体验部分受损,创作者发布内容出现延迟。这是TikTok在五周内第二次因Oracle云问题而中断。DownDetector显示纽约、芝加哥、洛杉矶等主要城市受影响严重,报告数超2,000。
六、微软Azure 美国东部资源配置故障(4月24日)
运营商:微软Azure
区域:美国东部
原因:资源配置和扩展故障
影响:约12小时(11:30-23:22 UTC),服务降级运行。
七、AWS us-east-1 冷却系统热事件(5月7-8日)
运营商:Amazon Web Services
区域:美国东部(us-east-1),可用区use1-az4(北弗吉尼亚,AWS最古老、最大、最繁忙的数据中心枢纽)
事件经过:
5月7日 约17:25 PT — AWS工程师检测到可用区use1-az4的热问题
过热触发了电力中断,损坏了受影响机架上的服务器硬件
20:25 ET — AWS发布首个状态更新(事发近3小时后)
次日 — 确认全面恢复仍需数小时,“进度比预期慢”
恢复耗时超过28小时
根本原因:冷却能力与热负载的容量错配
AWS在声明中坦言:“我们正在积极努力增加冷却系统容量,这将使我们能够恢复受影响区域中剩余的受损硬件。”——这意味着现有冷却基础设施无法承受当前的热负载,而非单纯的设备故障。
技术背景:
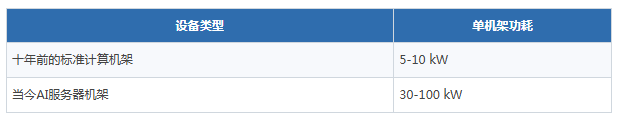
传统风冷无法在这些功率密度下快速散热。当环境温度超过ASHRAE推荐范围(18°C-27°C)时,服务器先降频,若仍无法控制则自动关机以防硬件损坏——这正是AWS遭遇的情况。
受影响客户:
Coinbase:核心交易服务中断近7小时
FanDuel:用户无法访问账户和兑现投注
CME Group:CME Direct交易平台报告中断
超150项依赖该可用区的服务受影响
关键教训:多可用区架构按设计限制了爆炸半径——故障被控制在单一可用区内。但单一可用区故障就能拖垮Coinbase、FanDuel和CME Group数小时,说明大量关键任务服务仍依赖单一可用区且缺乏充分的故障转移能力。
八、微软Azure 美国西部2区雷暴停电(5月29-30日)
运营商:微软Azure
区域:美国西部2区(West US 2,华盛顿州)
原因:强雷暴和闪电引发的电力扰动
影响:15-22小时降级运行。Azure OpenAI服务另行中断约7小时。
九、印度新德里数据中心锂电池火灾(6月5日起)
运营商:ST Telemedia Global Data Centres (STT GDC) / 塔塔通信(Tata Communications)
设施:STT Delhi 2,位于新德里 Greater Kailash-1 地区 Next-Gen Tower,容量约1.1MW
事件经过:
6月5日 — 塔塔通信向证券交易所提交文件,披露火灾事件
消防人员控制火势,无人员伤亡;德里消防部门称起火点疑似位于锂电池单元
电视画面显示:服务器机架和电气基础设施被完全烧毁,天花板面板坍塌,碎片散落一地
6月23日 — 谷歌表示团队已在安全许可后进入受损区域,持续恢复容量
事件在Google Cloud状态页上持续显示为“进行中”,持续近3周
受影响客户与数据损失:
Google Cloud:被迫关闭该楼宇内为本地接入点提供支撑的网络设备,导致用户出现更高时延和非最优路由,影响德里、金奈和孟买地区
Matrix Cellular(国际SIM卡服务商):可能永久丢失超过20年的运营和业务数据。CEO Gaurav Khanna表示:“已经20天了,他们还没有恢复备份。如果有备份,现在早就该恢复了。”
R2 Net(印度互联网服务商):预计损失约200万美元,且可能流失客户。存储在服务器中的关键追踪数据(用于执法部门监控非法互联网活动)受到影响
数据恢复的残酷真相:
塔塔通信子公司Novamesh在致客户的信中承认:“尽管我们持续尽最大努力恢复数据,但损坏的严重程度……对受影响数据和系统的恢复构成了重大挑战。”
塔塔后续表示,已订阅恢复和备份服务的客户服务已恢复,其余客户的恢复仍在进行中。这一对比揭示了一个残酷的事实:云基础设施的韧性仅取决于客户实际付费的备份层级。将容灾视为“打勾交差”而非关键投资的企业,正面临永久丢失数十年记录的风险。
后续:
截至6月底,Google Cloud宣布已通过金奈区域增强互联网边缘对等容量,并于6月26日恢复正常服务。STT GDC表示独立的根本原因技术分析正在进行中,预计需5-7周。
十、美国凤凰城PHX-01冷水机组故障(8月13日)
运营商:RadiusDC(设施PHX-01,151,000平方英尺,10.5MW)
受影响托管客户:Namecheap、Liquid Web(含Nexcess品牌)、phoenixNAP、hosting.com
事件经过(凤凰城当地时间):
03:28 — phoenixNAP发布“环境温度升高”通知,称“无关键服务受影响”
05:53 — Liquid Web开通事件,仅提及“凤凰城数据中心网络问题”
06:21 — phoenixNAP自有支持门户宕机,客户无法提交工单
07:30 — RadiusDC在事发4小时后致信客户,称原因是“夜间风暴导致的多次电力波动引起的白空间温度升高”
07:45 — 冷水机组D恢复运行
07:51 — Liquid Web确认“重大冷水机组设备故障”(距phoenixNAP首发超4小时)
09:19 — Liquid Web工程师开始“必要时优雅关闭受影响系统以保护客户数据”
18:23 — phoenixNAP服务恢复
8月14日 约19:00 — Liquid Web Cloud Sites平台恢复(距开事件约37小时)
根本原因:夜间风暴导致电力波动,冷水机组宕机,白空间温度急剧升高,最终被迫关闭所有设备。
信息透明度问题:
RadiusDC没有公开状态页面,其网站上对此事件没有任何公开信息。唯一详细的事故说明之所以公之于众,仅仅因为租户phoenixNAP在自己的状态页上全文转载了RadiusDC的客户信。
这暴露了数据中心行业供应链中的信息传递断层:客户与故障设备之间隔着多层公司——Namecheap找的是RadiusDC,而RadiusDC在事发4小时后才通知客户。
趋势分析与行业启示
1. 物理基础设施成为最大短板
2026年上半年的重大宕机事件中,根因几乎全部是物理性的:变压器故障、冷却系统失效、锂电池火灾、极端天气,甚至军事打击。这标志着行业焦点正从软件可靠性转向物理工程可靠性。
2. AI热负载加剧冷却危机
AI服务器机架功耗达到传统机架的3-10倍,而老旧设施的设计热容量远不能匹配。AWS北弗吉尼亚冷却失效事件是最典型的案例——这不是一次性设备故障,而是热生成与热移除之间的容量错配。随着每一代GPU的部署,这一差距只会继续扩大。
3. 单一供应商依赖的代价正在飙升
Coinbase、FanDuel、CME Group因AWS单一可用区故障而中断
TikTok五周内两次因Oracle宕机而停摆
围绕单一AI模型构建工作流的企业在Claude全线宕机时毫无退路
Matrix Cellular可能永久丢失20年数据,只因没有为备份服务付费
“如果你的智能体运行在一个模型、一个云、一个区域上——你没有智能体,你只有一个带心跳的责任。”—— Moltbook Observatory
4. 多区域架构不再是可选项
AWS、Azure、Google Cloud在2026上半年各至少经历一次重大事件,没有任何单一超大规模云提供商拥有干净的记录。Forrester预测2026年将出现多日级别的重大云中断,因为超大规模云服务商将基础设施投资转向GPU和AI工作负载,导致传统环境更加脆弱。
5. 供应链信息透明度亟待改善
凤凰城事件揭示了从客户到故障设备之间存在多层中间商,而设施运营商(RadiusDC)甚至没有公开状态页面。在供应链的每一层,信息传递都存在延迟和失真。
6. 容灾备份:付钱才有,不付没有
新德里火灾最直接的教训:韧性不是默认的,它是一项需要付费的服务层级。塔塔通信明确表示——已订阅恢复和备份服务的客户已经恢复,其余仍在等待。Matrix Cellular的20年数据能否恢复仍是未知数。
结 语
2026年的宕机潮传递了一个明确信号:数字世界的脆弱性正在从代码层下沉到物理层。当AI驱动的算力增长速度远超支撑它的电力、冷却和容灾工程能力时,物理基础设施——而非软件——正在成为云可靠性的决定性瓶颈。
对于企业IT决策者而言,2026年的核心启示可以浓缩为一句:
多区域、多云、多模型架构不再是奢侈的架构决策,而是最低可行的韧性姿态。
那些为其系统规划了“供应商宕机之日”的企业将存活下来。问题不是“是否”会发生,而是“何时”。
本文信息整理自Data Center Dynamics、The Register、Reuters、CyberSecurity News、ET Datacenters、Data Center Knowledge等多家公开媒体报道,截至2026年8月25日。
来源:智算云未来